Может ли машинное обучение предсказывать антибиотикорезистентность?
Содержание
Общая информация
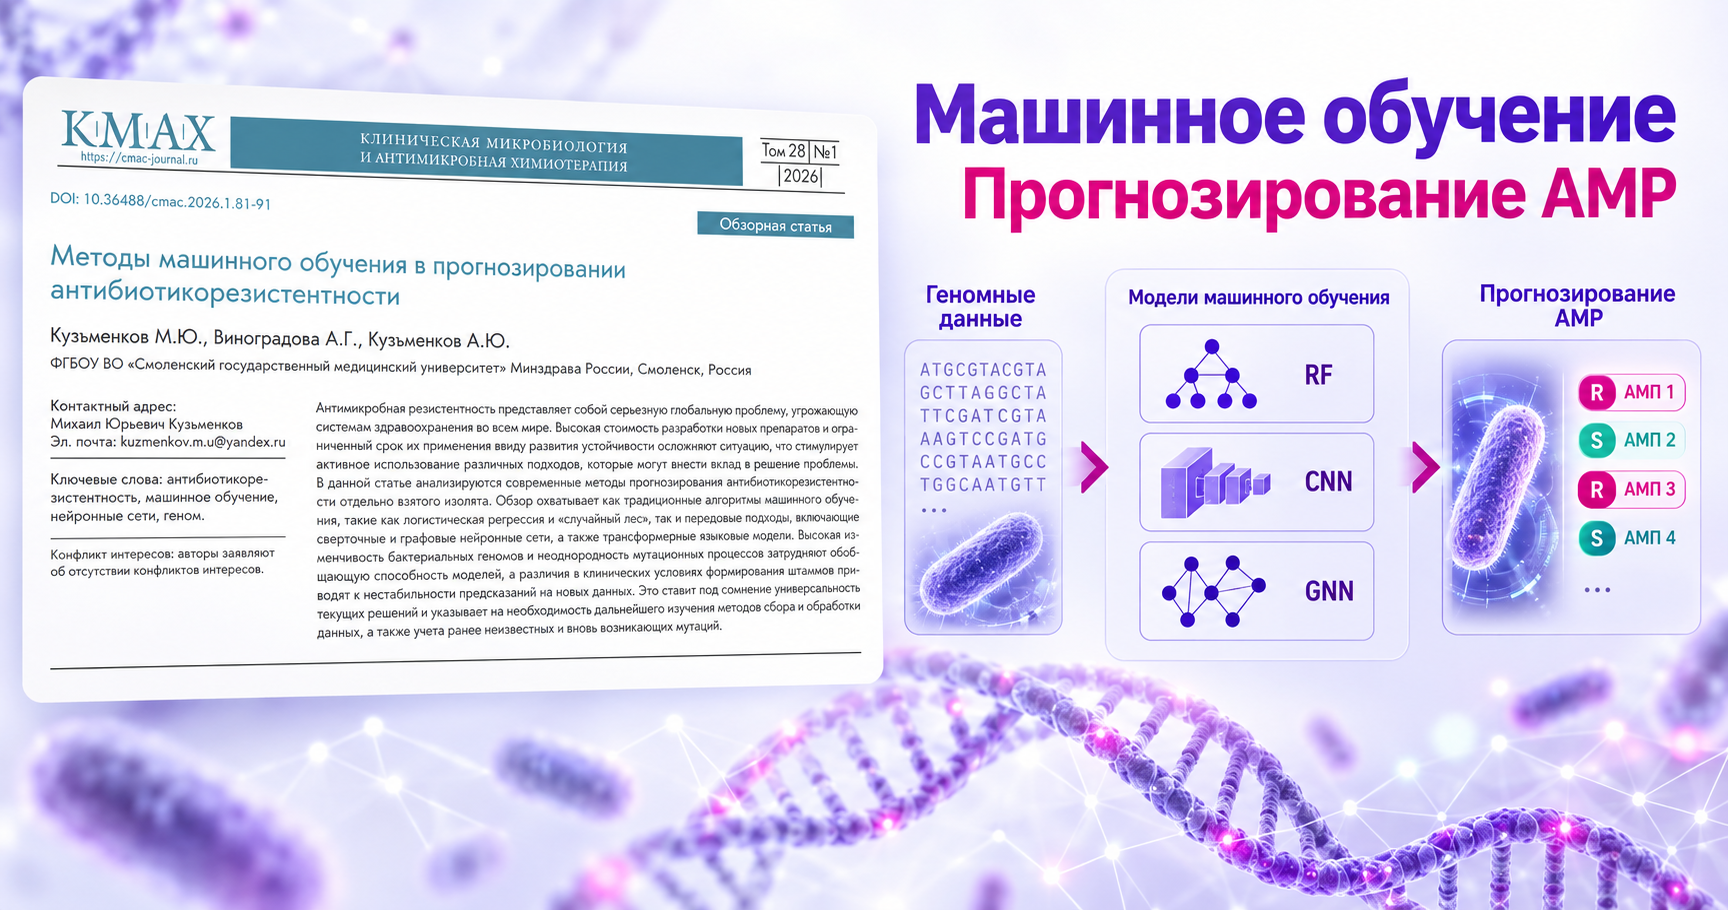
Статья: «Методы машинного обучения в прогнозировании антибиотикорезистентности»
Авторы: Кузьменков М.Ю., Виноградова А.Г., Кузьменков А.Ю.
Журнал: Клиническая микробиология и антимикробная химиотерапия, 2026, том 28, № 1, стр. 81–91
DOI: 10.36488/cmac.2026.1.81-91
Тип: обзорная статья
Скачать материал
Можно ли определить устойчивость бактерии к антибиотику не экспериментально, а рассчитать её по имеющимся данным?
Развитие машинного обучения сделало этот вопрос предметом активных исследований. Современные модели используют клинические характеристики пациентов, результаты лабораторных исследований, отдельные генетические признаки и полные геномные последовательности бактерий. Для анализа применяются как относительно простые алгоритмы, так и глубокие нейронные сети и трансформерные модели.
В журнале «Клиническая микробиология и антимикробная химиотерапия» опубликован обзор «Методы машинного обучения в прогнозировании антибиотикорезистентности», посвящённый современному состоянию этого направления.
Главный вопрос заключается уже не в том, способно ли машинное обучение обнаруживать закономерности, связанные с антибиотикорезистентностью, а в другом:
насколько надёжно такие закономерности позволяют предсказывать фенотип устойчивости у новых клинических изолятов?
Что именно можно прогнозировать?
Под общим выражением «прогнозирование антибиотикорезистентности» могут скрываться разные задачи.
Модель может определять:
- вероятность устойчивости микроорганизма к конкретному препарату;
- категорию «чувствительный/устойчивый»;
- вероятность наличия определённого механизма резистентности;
- класс антимикробных препаратов, с которым связан обнаруженный ген;
- минимальную подавляющую концентрацию – МПК.
Последняя задача особенно интересна.
Прогнозирование категории чувствительности является задачей классификации: модель должна отнести изолят к одной из заранее определённых групп.
Прогнозирование МПК представляет собой более сложную задачу регрессии, поскольку модель должна получить количественное значение, характеризующее степень подавления роста микроорганизма препаратом.
Именно количественный прогноз потенциально позволяет приблизить геномный анализ к традиционному фенотипическому исследованию.
Клинические данные: можно прогнозировать риск, но не геном бактерии
Один из подходов заключается в использовании информации о пациенте.
В модели могут включаться возраст, предшествующее применение антибиотиков, длительность госпитализации, пребывание в отделении реанимации, локализация инфекции, сопутствующие заболевания и другие характеристики.
Такие алгоритмы способны выявлять пациентов, у которых вероятность инфекции, вызванной устойчивым микроорганизмом, выше.
Однако существует принципиальное ограничение.
Клинические характеристики пациента связаны с антибиотикорезистентностью опосредованно. Они отражают условия, в которых вероятность появления определённых устойчивых микроорганизмов увеличивается, но непосредственно не описывают механизм устойчивости конкретного изолята.
Поэтому модели, хорошо работающие в одной медицинской организации или популяции пациентов, могут значительно хуже переноситься в другие условия.
Для непосредственного прогнозирования свойств микроорганизма более информативным источником становятся данные его генома.
От поиска известных генов к анализу генома
Классический геномный анализ антибиотикорезистентности во многом основан на поиске уже известных генов и мутаций.
Такой подход хорошо работает, если:
- механизм устойчивости известен;
- его генетическая детерминанта описана;
- наличие детерминанты достаточно надёжно связано с фенотипом.
Но антибиотикорезистентность не всегда определяется одним геном.
Фенотип может зависеть от сочетания нескольких мутаций, регуляторных изменений, числа копий генов, активности эффлюксных систем, изменений проницаемости клеточной стенки и генетического контекста.
Именно здесь возникает потенциальное преимущество машинного обучения.
Вместо заранее заданного правила:
«обнаружен ген X → ожидается устойчивость к препарату Y»
модель может искать значительно более сложные комбинации признаков непосредственно в больших массивах геномных и фенотипических данных.
Даже относительно простые модели могут показывать высокие результаты
Для анализа геномных данных необязательно использовать самые сложные нейронные сети.
В одном из рассмотренных в обзоре исследований для прогнозирования устойчивости Escherichia coli использовались логистическая регрессия, метод опорных векторов, «случайный лес» и свёрточная нейронная сеть.
Геном предварительно преобразовывали в набор генетических признаков, после чего модели прогнозировали устойчивость к ципрофлоксацину, цефотаксиму, цефтазидиму и гентамицину.
Для ципрофлоксацина алгоритм «случайный лес» достиг AUC 0,96.
Но этот результат показывает одновременно и одну из главных особенностей подобных исследований.
Модель работала не непосредственно со всем необработанным геномом. До обучения выполнялись выделение, преобразование и отбор генетической информации.
Таким образом, качество прогноза зависит не только от алгоритма, но и от того, как представлен геном и какие признаки из него были извлечены.
Нейронные сети позволяют учитывать взаимодействие генов
Следующий уровень сложности – использование глубоких нейронных сетей.
Свёрточные нейронные сети могут выявлять локальные закономерности в нуклеотидных последовательностях. Вместо анализа отдельной мутации они способны учитывать взаимное расположение изменений внутри генов.
Интересен и многозадачный подход, при котором одна модель одновременно прогнозирует устойчивость к нескольким препаратам.
В исследованиях Mycobacterium tuberculosis такой подход позволял использовать общие генетические закономерности, связанные с устойчивостью сразу к нескольким антимикробным препаратам.
Это отражает биологическую реальность: механизмы устойчивости не всегда существуют независимо друг от друга.
От нейронной сети к генетическому графу
Геном можно представить не только как последовательность нуклеотидов.
Гены взаимодействуют между собой, продукты генов участвуют в общих биологических процессах, а изменение одного механизма может влиять на проявление другого.
Поэтому для прогнозирования антибиотикорезистентности исследуются графовые нейронные сети.
В такой модели каждый ген можно представить как отдельный узел, а известные функциональные взаимодействия между генами – как связи между этими узлами.
В одном из рассмотренных исследований использовалось сочетание свёрточной и графовой нейронных сетей для прогнозирования МПК у Mycobacterium tuberculosis и Pseudomonas aeruginosa.
Модель учитывала не только последовательность отдельных генов, но и известные белок-белковые взаимодействия.
Коэффициент детерминации для прогнозируемой МПК составил R² = 0,66, а корреляция между прогнозируемыми и фактическими значениями МПК – 0,87.
Это интересный переход от простой классификации «устойчив/чувствителен» к попытке количественного воспроизведения фенотипа.
Можно ли читать геном как текст?
Ещё одно направление связано с трансформерами – архитектурами нейронных сетей, первоначально получившими развитие при обработке естественного языка.
Причина аналогии достаточно понятна.
Текст представляет собой последовательность символов и слов, значение которых зависит от окружающего контекста.
Геном также является последовательностью символов, где значение отдельного участка зависит от его положения и взаимодействия с другими участками.
Так появились модели семейства DNABERT, в которых последовательности ДНК преобразуются в небольшие фрагменты – своеобразные «слова» генетического языка.
Задача такой модели заключается не обязательно в непосредственном прогнозировании резистентности.
Сначала нейронная сеть формирует числовое представление генетической последовательности – вектор, содержащий информацию о её особенностях.
Полученное представление затем может использоваться другой моделью для решения прикладной задачи, например прогнозирования антибиотикорезистентности.
На момент подготовки обзора заметных исследований по непосредственному применению DNABERT и DNABERT-2 для прогнозирования устойчивости бактерий к антибиотикам ещё не было.
А что насчёт больших языковых моделей?
Предпринимаются попытки использовать и генеративные языковые модели.
Однако здесь особенно хорошо видна разница между универсальной языковой моделью и специализированным биоинформатическим алгоритмом.
Если обычной большой языковой модели просто передать последовательность ДНК и попросить определить связанный с ней класс антибиотикорезистентности, результат оказывается неудовлетворительным.
Качество значительно повышается после добавления информации из специализированных баз данных или дополнительного обучения модели.
Но возникает закономерный вопрос: если для прогноза сначала требуется найти похожий известный ген в базе данных, не оказывается ли обычный специализированный поиск более простым и воспроизводимым решением?
Поэтому применение генеративных моделей к задаче антибиотикорезистентности само по себе ещё не является преимуществом.
Ценность появляется тогда, когда модель способна извлекать новые закономерности, которые не сводятся к поиску уже известного гена.
От генов к «языку» всего генома
Более фундаментальный подход реализован в моделях семейства Evo.
Такие системы обучаются непосредственно на огромных массивах геномных последовательностей и пытаются выявить общие закономерности организации генома.
Они могут оценивать влияние мутаций, особенности экспрессии, функциональное значение отдельных последовательностей и другие биологические характеристики.
Особенно интересна возможность формирования внутренних числовых представлений генома, которые затем могут использоваться для других аналитических задач.
Пока возможность применения таких моделей непосредственно для прогнозирования антибиотикорезистентности остаётся исследовательским направлением.
Но сама идея важна: вместо формирования вручную заданного списка известных генов устойчивости алгоритм потенциально может получить более комплексное представление о генетическом контексте микроорганизма.
Почему высокая точность модели ещё ничего не гарантирует
Одна из наиболее важных проблем машинного обучения – обобщающая способность.
Модель может демонстрировать очень высокие показатели на данных, похожих на те, на которых она обучалась.
Но затем появляется новая выборка:
- другой регион;
- другая медицинская организация;
- другая структура циркулирующих клонов;
- новые механизмы устойчивости;
- ранее редкая мутация;
- другой способ формирования обучающих данных.
И качество прогноза может измениться.
Для бактерий эта проблема особенно значима из-за высокой вариабельности геномов и постоянной эволюции механизмов устойчивости.
Поэтому AUC, чувствительность или специфичность конкретной модели нельзя автоматически переносить на другую популяцию микроорганизмов.
Высокое качество на тестовой выборке не эквивалентно универсальной способности прогнозировать антибиотикорезистентность.
Самая сложная часть – не нейронная сеть
Пожалуй, один из наиболее важных выводов обзора заключается в том, что дальнейший прогресс может быть связан не столько с созданием ещё более сложных архитектур, сколько с улучшением работы с геномными данными.
Многие современные модели показывают хорошие результаты после предварительного отбора:
- известных генов резистентности;
- известных мутаций;
- наиболее вариабельных участков;
- генов, ранее ассоциированных с конкретным фенотипом.
Получается парадокс.
Машинное обучение должно помогать находить новые закономерности, но для достижения высокой точности модель нередко заранее ограничивают уже известными механизмами.
Следующий этап развития таких методов должен позволить учитывать:
известные механизмы + новые варианты + сочетания изменений + генетический контекст.
Именно способность выявлять ранее неизвестные связи между генотипом и фенотипом может стать одним из основных преимуществ машинного обучения.
Для обучения нужен фенотип
Есть ещё один принципиальный момент.
Чтобы научить модель прогнозировать антибиотикорезистентность по геному, необходимо сообщить ей, какой фенотип соответствовал каждому геному в обучающей выборке.
То есть исходными данными становятся пары:
геном → результат определения чувствительности
или, ещё лучше:
геном → количественное значение МПК
Таким образом, развитие геномного прогнозирования не уменьшает значение качественного фенотипического тестирования.
Напротив, фенотип становится эталоном, на котором обучаются и проверяются новые алгоритмы.
Этот вывод хорошо согласуется с современной позицией EUCAST: геномное прогнозирование быстро развивается, но для большинства сочетаний «микроорганизм – препарат» пока не может рассматриваться как универсальная замена фенотипического определения чувствительности.
Подробнее об этом мы писали в материале «От генотипа к фенотипу: EUCAST о прогнозировании чувствительности к антибиотикам по данным WGS».
Почему совместный анализ генотипа и фенотипа становится особенно важным
Для построения и проверки прогностических моделей недостаточно иметь отдельно коллекцию геномов и отдельно результаты определения чувствительности.
Необходимо связывать эти данные на уровне конкретного изолята.
Тогда становится возможным исследовать:
- какие генетические маркеры действительно сопровождаются фенотипической устойчивостью;
- как изменяется МПК при наличии конкретной мутации;
- какие сочетания механизмов оказывают наибольшее влияние на фенотип;
- почему одинаковый генетический маркер может сопровождаться различными результатами определения чувствительности;
- какие устойчивые фенотипы пока не объясняются известными генетическими механизмами;
- насколько закономерности, выявленные в одной популяции, воспроизводятся в другой.
Именно такие связанные массивы становятся основой для разработки моделей, способных учитывать локальную структуру антибиотикорезистентности.
Генотип и фенотип в АБиоГрам
АБиоГрам позволяет совместно анализировать генетические маркеры антимикробной резистентности и результаты фенотипического определения чувствительности.
Важно, что речь идёт не о замене фенотипического тестирования прогнозом искусственного интеллекта.
Совместный анализ позволяет изучать соответствие между обнаруженным генетическим механизмом и его фактическим фенотипическим проявлением.
На уровне одного изолята может формироваться связанная последовательность:
микроорганизм → генетический маркер → препарат → фенотипический результат
Это позволяет выявлять ситуации, когда:
- генетический маркер присутствует, но фенотипическая устойчивость отсутствует;
- устойчивость определяется фенотипически, но известный маркер не обнаруживается;
- несколько механизмов присутствуют одновременно;
- один и тот же маркер связан с различным уровнем чувствительности;
- структура генотип-фенотипических связей изменяется во времени или между медицинскими организациями.
Такие данные представляют самостоятельную аналитическую ценность.
Кроме того, их накопление создаёт основу для последующей разработки и внешней проверки моделей машинного обучения на реальных локальных данных.
Что в итоге?
Машинное обучение уже способно находить сложные связи между геномом бактерии и антибиотикорезистентностью.
Для отдельных задач исследовательские модели демонстрируют очень высокие показатели качества. Развиваются подходы, способные прогнозировать не только категории устойчивости, но и количественные значения МПК.
Однако сегодня основным ограничением становится не отсутствие достаточно сложных нейронных сетей.
Проблема заключается в другом:
какие данные получает модель, какие признаки из них извлекаются и сохранится ли обнаруженная закономерность на новых клинических изолятах.
Поэтому следующим этапом развития прогнозирования антибиотикорезистентности, вероятно, станет сочетание трёх компонентов:
качественный фенотип + геномные данные + методы, способные учитывать генетический контекст.
Именно на таких данных машинное обучение сможет перейти от воспроизведения уже известных механизмов устойчивости к выявлению новых и клинически значимых генотип-фенотипических закономерностей.
Источник
Кузьменков М.Ю., Виноградова А.Г., Кузьменков А.Ю.
Методы машинного обучения в прогнозировании антибиотикорезистентности.
Клиническая микробиология и антимикробная химиотерапия. 2026;28(1):81–91.
DOI: 10.36488/cmac.2026.1.81-91